
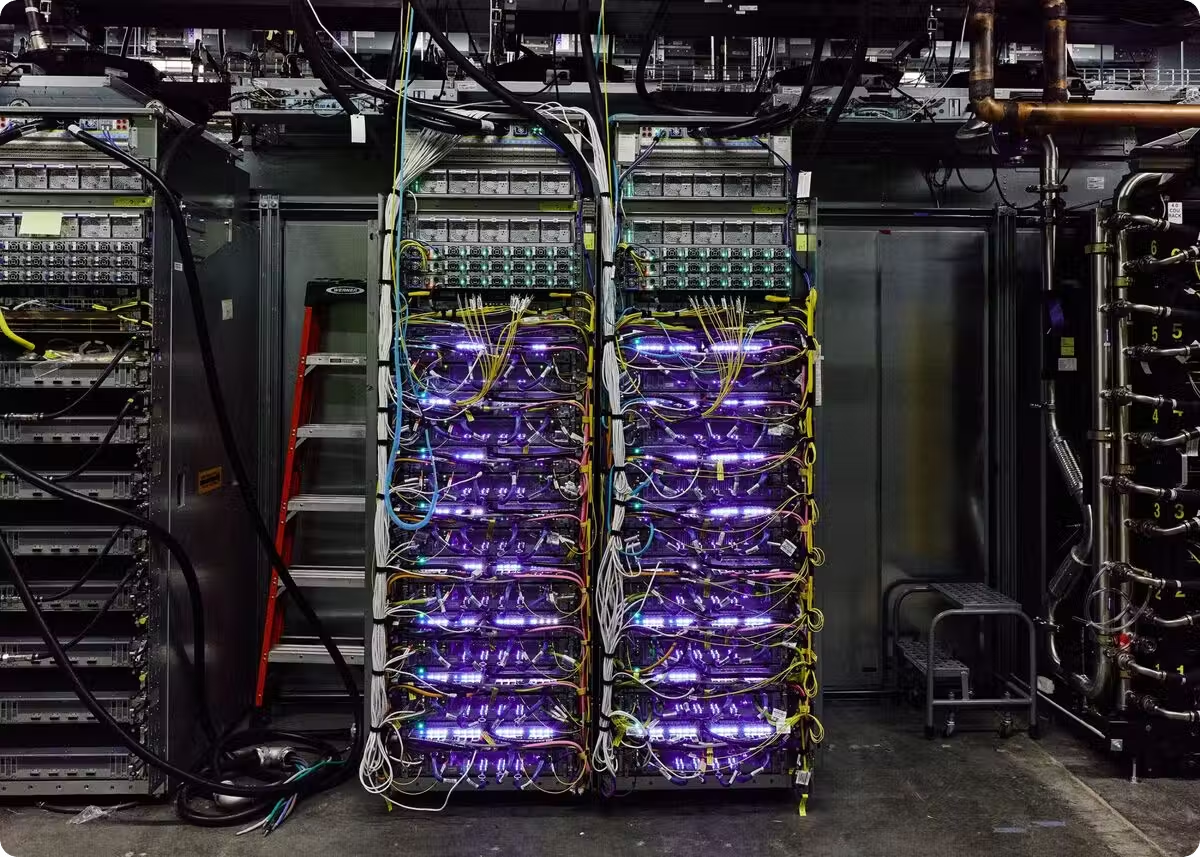
Alphabet Inc., compania mamă a Google, este în procesul de lansare a unei game mai largi de procesoare pentru inteligență artificială. Această mișcare strategică vizează capitalizarea ascensiunii rapide a Google ca principal rival al companiei NVIDIA pe o piață estimată la sute de miliarde de dolari.
În centrul acestui demers se află introducerea a două noi variante ale Unităților de Procesare Tensoriale (TPU). Acestea sunt cipuri semiconductoare construite special pentru a dezvolta și executa software-ul de inteligență artificială.
Google a anunțat extinderea portofoliului de procesoare TPU de generația a opta prin introducerea a două sisteme noi: TPU 8i Max și TPU 8tx, specializate în procesarea securizată a informațiilor și gestionarea volumelor mari de date contextuale. Aceste cipuri servesc antrenării și rularii modelelor Gemini, suportului pentru agenți AI autonomi și infrastructurii Google Cloud, fiind disponibile acum și clienților prin implementare directă în centrele de date proprii, ajungând la aproape 100 de clienți, inclusiv instituții financiare, universități și laboratoare de cercetare. TPU 8tx, integrat cu procesoare AMD personalizate, asigură protecția datelor sensibile direct la nivel de hardware, păstrându-le criptate chiar și în timpul procesării active, eliminând necesitatea decriptării în memorie. Rețeaua Boardfly de joasă latență integrată permite agenților AI să execute sarcini complexe multi-etape cu o viteză de două ori superioară TPU 8t, fără impact semnificativ asupra performanței. Un singur sistem TPU 8tx permite simultan antrenarea, personalizarea și optimizarea modelelor cu date confidențiale, inclusiv distilare și învățare prin recompensă, fără a necesita transferul datelor între clustere separate.
Lansarea celor noi configurații completează gama de patru sisteme TPU 8t, 8i, 8tx și 8i Max, dezvoltate în premieră într-un singur an, urmate celor inițial anunțate în aprilie 2026 la Google Cloud Next. Noile sisteme, TPU 8i Max și TPU 8tx, vizează provocările specifice integrării agenților AI autonomi: securitatea avansată la nivel de hardware și procesarea unor ferestre de context de ordinul milioanelor de tokenuri. Amin Vahdat, Chief Technologist Google, a subliniat necesitatea acceleratoarelor capabile să gestioneze raționamentele agenților AI pe contexte extinse și să ofere capabilități de criptare specializate pentru industriile reglementate. Echipa Google a declarat că obiectivul este simplificarea accesului la tehnologia TPU, combinând arhitectura modulară personalizată cu un ecosistem software deschis, incluzând recenta publicare a TorchTPU pentru PyTorch, pentru a accelera dezvoltarea hardware-ului. Analiza complexă a conținutului video lung sau a codului sursă extins de către agenți AI simultani întâlnește adesea coliziunea provocată de limitările lățimii de bandă a memoriei. TPU 8i Max dublează puterea de procesare, capacitatea SRAM și lățimea de bandă HBM față de TPU 8i standard, garantând acces constant la date și rularea fluidă a sarcinilor de lucru masive. Integrarea a dublului de cipuri în același spațiu de rack asigură o densitate de calcul și o eficiență energetică semnificativ mai mari pentru centrele de date. Gama completă TPU 8t, 8i, 8tx și 8i Max oferă soluții distincte pentru fiecare etapă a ciclului de viață al agenților AI: antrenarea la scară largă, raționamentul cu latență scăzută, procesarea securizată a datelor și managementul contextului de mare dimensiune.
Google a extins portofoliul de Generația a VIII-a TPU cu două noi cipuri specializate: TPU 8tx și TPU 8i Max. Anunțul marchează prima dată când compania introduce patru sisteme TPU distincte într-un singur an, o acelarare fără precedent, ce urmează debutului în aprilie 2026 al TPU 8t și TPU 8i. Amenințările privind calculul confidențial se referă la menținerea datelor criptate chiar și în timpul procesării active. TPU 8tx, bazat pe același siliciu cu TPU 8t și asociat cu procesoare AMD EPYC de generația a cincea, încorporează securitatea la nivelul hardware-ului, izolând datele sensibile și ponderile modelelor chiar în timp ce sunt utilizate activ. Portofoliul complet de generația a VIII-a acoperă etapele dezvoltării AI: TPU 8t (antrenarea modelelor mari, optimizat pentru inteligență utilă per watt), TPU 8i (raționament în timp real cu latență scăzută), TPU 8tx (inferență confidențială și antrenament privat mic) și TPU 8i Max (ferestre de context masive și densitate maximă per rack). Pentru agenți de chat sau de apelare a instrumentelor cu latență scăzută, TPU 8i este disponibil astăzi, iar TPU 8i Max va fi orientat spre rezolvarea gâtuirilor de descifrare prin rețeaua Boardfly și SRAM-ul mai mare. Deși prețul nu a fost specificat, Google Cloud vânează dolarii enterprise (care concurează cu Microsoft Azure AI și Amazon Bedrock) și menține capacitatea de a utiliza noutăți în trimestrele următoare. Pentru lucrări confidențiale, distilarea modelelor la frontiera pentru documente private sau execuția RL pe datele clientului necesită securitate în utilizare pentru a evita riscurile de audit. Google lansează un software dedicat agenților de calcul pentru Claude Code și Cursor, Agent Compute Engine pentru a elibera memoria off-chip și TPU Sync pentru cache-urile KV. Oferind un portofoliu modular de generația a VIII-a, Google intenționează să adapteze capacitatea la nevoile clienților enterprise pentru antrenare și inferență. TorchTPU face ca TPUs să fie ușor de utilizat pentru dezvoltatori, integrându-i cu PyTorch și alte framework-uri open source. Conform raportărilor preliminare, Google nu a oferit date clare privind prețurile sau disponibilitatea generală. Antrenamentele cu date confidențiale devin tot mai solicitate de entitățile guvernamentale și firmele din sectoarele reglementate. Noile componente de software, precum Agent Compute Engine, permit funcționarea mai eficientă a agenților AI pe platformele hardware TPU. Nvidia și AMD se angajează direct sau indirect în această luptă pentru performanță și eficiență energetică a IA agentică. Menținerea unei pârghii competitive în fața NVIDIA, Microsoft și Amazon prin inovații de hardware și software. Implementarea de rețea optică a circuitelor și integrarea cu K8s simplify managementul șirurilor TPU. Strategia de vânzare se concentrează pe companiile de top, care caută soluții scalabile și sigure. Competiția pe piața de calcul este condusă de nevoile de scalabilitate și costuri reduse. Performanțele raportate sugerează o reducere considerabilă a timpului de procesare a sarcinilor de date complexe. Noile implementări ar putea schimba modul în care se construiesc centrele de date. Noile componente de hardware sunt optimizate pentru a gestiona sarcinile de date avansate, oferind performanțe superioare.
Google a introdus TPU 8tx pentru sarcini confidențiale și TPU 8i Max pentru inferențe pe ferestre contextuale extinse pe 9 noiembrie 2026. Postarea oficială a Google, semnată de Amin Vahdat, confirmă că noile sisteme reutilizează siliciul existent de generația a opta, reconfigurând doar pachetul, memoria și rețeaua. Capabilitățile cheie ale TPU 8tx includ: rețeaua Boardfly cu latență scăzută, care reduc latența cu până la 2x față de TPU 8t și are un penalizare de performanță aproape nulă; personalizarea „all-in-one”, care permite fine-tuning, distilarea modelelor și învățarea prin recompensă (RL) pe un singur sistem, fără a muta datele sensibile între cluster separate. TPU-urile sunt utilizate acum la scară largă pentru antrenarea modelului Gemini, sarcinile de agenți AI și serviciile Google Cloud, unii clienți implementându-le direct în centrele lor de date. Până la sfârșitul anului, Google declară că are aproape 100 de clienți externi. Antrenarea fină sau RL pe înregistrări reglementate se va adapta pe TPU 8tx (când va fi disponibil), folosind calea confidențială pentru a păstra ponderile și activările într-un domeniu protejat. Pentru contexte de repo sau video cu durata de mai multe ore, TPU 8i Max utilizează pachetul dual de cipuri pentru a ținti lățimea de bandă a memoriei per rack. Agilitatea de proiectare a unui astfel de ciclu de patru sisteme pe an arată că capacitățile de proiectare a hardware-ului intern Google s-au maturizat, permițând răspunsul rapid la tiparele de sarcini de lucru emergente, cum ar fi agenții AI. Luarea în considerare a memoriei per sesiune este vitală pentru agenții multipli, iar creșterea lățimii de bandă poate elimina depășirea memoriei RAM pentru anumite aplicații. Pentru a evita riscul de audit și a simplifica fluxurile de lucru pentru clienții reglementați, Google oferă un TPU special destinat calculului confidențial. Microsoft se concentrează pe Maia 300 și Microsoft Azure AI, Nvidia își menține dominarea prin GPU-uri, iar Oracle dezvoltă opțiuni multi-cloud. GKE Dynamic Slicing permite asamblarea TPU în configurații mai mari sau mai mici, accelerând lansările lucrărilor. Datele preliminare indică faptul că majoritatea specialiștilor în AI consideră că specializarea este calea viitorului pentru cloud computing. Google declară că noile cipuri au fost proiectate pentru a rezolva probleme de memorie ale aplicațiilor de inteligență artificială agentică. Investițiile masive în dezvoltarea de hardware personalizat nu sunt doar pentru a obține performanțe brute, ci pentru a îmbunătăți prețurile, eficiența și scalabilitatea. Google a confirmat intenția de a continua să lanseze soluții hardware optimizate pentru cerințele actuale și viitoare ale agenților de inteligență artificială. Se observă o tendință de customizare a hardware-ului pentru fiecare furnizor de cloud major, datorită diferențelor în workload-urile utilizatorilor finali. Performanța și scalabilitatea TPU depind de arhitectura flexibilă de configurare a nodurilor fizice. Google are nevoie de capacitate extinsă pentru a satisface nevoile de calcul pentru echipamentele de procesare a datelor mass-market. Google intenționează să mențină avantajul tehnologic prin continuarea cercetării în domeniul acceleratoarelor AI. Google se bazează pe tehnologiile emergente pentru a anticipa nevoile viitoare ale industriei. EforturileGoogle sunt consolidate pentru a oferi soluții scalabile, sigure și eficiente.
După lansările din aprilie 2026 care au promis o performanță de antrenare îmbunătățită de 2,7 ori (TPU 8t) și o eficiență a prețului de inferență îmbunătățită cu 80% (TPU 8i), noua linie completează gama pe patru sisteme, integrată recent cu PyTorch pentru a facilita dezvoltatorul obișnuit. TPU 8i Max abordează „zidul memoriei” atunci când zeci de agenți AI lucrează simultan asupra unui cod sursă sau al ore lungi de video. Combinând două cipuri TPU 8i într-un singur pachet, Google obține dubla putere de calcul, dubla SRAM și dubla lățimea de bandă HBM față de un TPU 8i standard. Google a lansat un stack de software pentru dezvoltatori, inclusiv TorchTPU deschis pentru PyTorch nativ, suport pentru vLLM și SGLang, un simulator de agenți TPU pentru Claude Code și Cursor, Agent Compute Engine pentru a muta memoria inactivă off-chip, TPU Sync pentru cache-urile KV masive și GKE Dynamic Slicing cu comutare optică a circuitelor. Cercetătorii care utilizează principal CUDA și nu au un contract GCP pot utiliza TorchTPU pentru portare, dar CUDA rămâne standardul implicit pentru ecosistemul laptopului și al dezvoltării. Companiile care evaluează GCP pentru configurațiile de optima generație ar trebui să verifice dacă contractul include timeline-uri de acces la generația a VIII-a, nu doar discounturi pentru utilizarea angajată pe instanțele mai vechi. Integrarea cu PyTorch și vLLM simplifică portarea pentru dezvoltatorii existenți, evitând rescrierea nucleelor pentru a profita de avantajul agenților hardware AI. Fără măsuri de securitate, distribuția între cluster ar necesita transferul datelor, expunând riscurile de confidențialitate. Google propune să mențină procesarea într-un singur stack securizat. Google se angajează să rivalizeze direct cu Nvidia, dar nu prin generalizare, ci prin specializarea pentru anumite sarcini de lucru (ex: agenți AI, confidențialitate). Noul TPU 8i Max dublează capacitatea HBM, SRAM și performanța de calcul față de TPU 8i. Omul de afaceri Thomas Kurian, CEO Google Cloud, a anunțat în cadrul apelului trimestrial de profitabil Q3 2026 faptul că aproape 100 de clienți folosesc deja TPU-uri. Google a continuat să dezvolte platforma TPU pentru a acoperi cererile de nișă și a menține un avantaj competitiv față de alte furnizori de platforme. Lansarea de patru versiuni de chipuri TPU într-un an semnifică o viteză de dezvoltare fără precedent. Noile cipuri au fost lansate ca răspuns la o creștere semnificativă a cererii de către agenții AI. Agent Compute Engine vizează reducerea timpilor morți ai agenților care așteaptă răspunsuri exterioare, muțiți memoria temporară pe chip-uri secundare. Adaptarea către modele generative ai agenților cere o flexibilitate suplimentară la nivelul memoriei. După deciziile recente, Google intenționează să dezvolte TPU-uri pentru aplicații de viitor, axate pe calcule de natură complexă. Extinderea portofoliului reflectă creșterea utilizării modelului Gemini. Dezvoltarea modulară este cheia inovației rapide în domeniul hardware. Adaptarea la tehnologiile emergente rămâne prioritatea principală a departamentului Google Infrastructure.
Crearea unui cip nou implică plasarea a miliarde de tranzistori pe silicon, un proces multianual. În schimb, Google a conceput TPU-urile ca blocuri modulare într-o arhitectură AI Hypercomputer, ajustând memoria, rețeaua optică și securitatea în jurul cipurilor existente, ceea ce permite livrarea de supercomputere specializate în luni, nu ani. Configurarea duală de cipuri a lui 8i Max oferă o densitate de calcul și o eficiență energetică semnificativ mai mari, plasmând dublu de siliciu în același spațiu de rack. Pentru lucrări de pre-antrenament de frontieră la scară largă (peste 9.000 de cipuri), TPU 8t rămâne potențiala potrivire, evidențiată de Google pentru scalarea toroidală și antrenamentul puternic încărcat de inserții. Anularea la nivel de date center este crucială; companiile se confruntă cu necesitatea capacității pentru a alimenta și răci noile cipuri, care se adaugă constrângerilor de design de cipuri. Nu există achiziții mari anunțate pentru aceste chipuri specifice, ci mai degrabă un angajament de a integra soluția în fluxurile de lucru existente, iar performanța reală se va evalua ulterior. Oferta Google include pachetul TorchTPU pentru PyTorch, vLLM, SGLang și un simulator de agenți TPU pentru a facilita Claude Code și Cursor. Duplicarea unităților de calcul și a memoriei într-un spațiu de rack este esențială pentru soluționarea gâtuirilor cauzate de volumele mari de context generate de agenți. Potrivit CIO și VP Google Amin Vahdat, soluțiile pentru agenți AI sunt esențiale pentru gestionarea raționamentului și a contextului extins. Noile soluții sunt destinate special clienților care doresc să optimizeze prețurile și performanțele în sectorul de producție și cereri agentic. Această expansiune rapidă nu este doar pentru consum intern, ci reflectă și cererea clară venită din exteriorul Google. Noile TPU-uri includ suport avansat pentru aplicațiile de tip agent, care necesită adaptabilitate la fluxul de date variabil și complex. Google folosește strategii modulare, optimizând diverse subsisteme (memorie, rețea, risc de sejur) pentru a construi sistemul fără a aștepta un nou ciclu de siliciu. De la începutul anului, Google a lansat TPU 8t și TPU 8i, demonstrând capacitatea de a răspunde rapid la evoluția pieței de hardware. TorchTPU este un pachet open-source, facilitând tranziția dezvoltatorilor de la alte platforme. Google a atestat performanțe ridicate în testele interne, dar datele independente sunt absente. Noile produse au fost dezvoltate în paralel cu extinderea platformei GCP pentru a oferi flexibilitate. Noile sisteme vor fi implementate treptat, începând cu clienții interni și partenerii strategici. Sistemele noi pot fi adaptate pentru a rezista la varietăți mari de sarcini de lucru. Google folosește portofoliul său de TPU-uri pentru a susține dezvoltarea aplicațiilor de inteligenta artificiala de ultima generatie.